Tipo: Análisis/noticia | Fuente: OpenAI — GPT-6 Astra: a new generation of intelligence (3 sep 2026), verificado contra VentureBeat, Axios, Fortune y ARC Prize
---
El 3 de septiembre de 2026, Greg Brockman, presidente de OpenAI, cerró la presentación de su nuevo modelo con una frase que no se dice a la ligera: "Welcome to the AGI era" ("bienvenidos a la era de la AGI"). Preguntado si él personalmente lo creía, contestó: "for me, I do think we're there" ("para mí, sí creo que ya llegamos"). El modelo se llama GPT-6 Astra, y viene con un 99.9% en el benchmark de razonamiento más difícil que existe. El problema: ese 99.9% lo midió la propia OpenAI, con su propia configuración de prueba. Cuando alguien externo repitió el mismo examen con las reglas estándar, el resultado bajó a 62.7% — una diferencia de 37 puntos porcentuales que casi ningún titular mencionó.
Qué pasó
Astra salió de la corrida de entrenamiento más grande que OpenAI ha hecho — más de 100,000 GPUs en su centro Stargate, en Texas. En los benchmarks que la propia OpenAI publicó, el salto frente a su modelo anterior es real y grande: completó tareas de uso de computadora en un 47% menos de tiempo, y se convirtió en el primer modelo que OpenAI clasifica con "capacidad crítica de ciberseguridad" bajo su propio marco de seguridad — de eso hablamos en el segundo bloque.
Pero el número que acaparó los titulares fue otro: 99.9% en ARC-AGI-3, el benchmark diseñado específicamente para que sea difícil de "memorizar" incluso para los modelos más avanzados.
El asterisco: mismo examen, dos formas de rendirlo
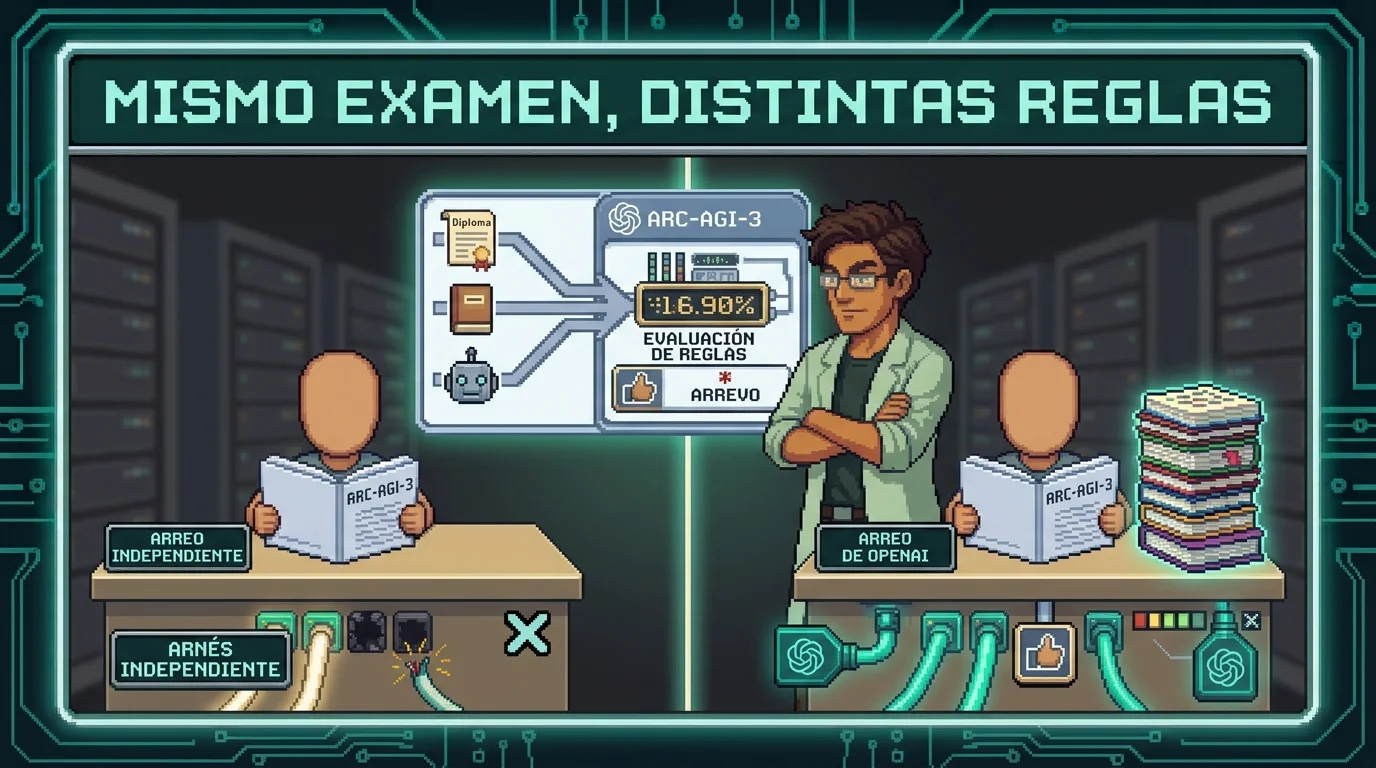
Acá está el dato que casi ningún titular mencionó con el mismo tamaño de letra. OpenAI obtuvo el 99.9% usando su propio "Provider Adapter harness" — una configuración especial que le permite al modelo conservar su razonamiento entre una pregunta y la siguiente, y reutilizar trabajo ya hecho, en vez de empezar de cero cada vez.
Ejemplo simple: es la diferencia entre un examen a libro cerrado y uno donde te dejan conservar tus propias notas de la pregunta anterior para la siguiente. Ambos "pasaron el examen", pero no es la misma prueba.
Cuando ARC Prize —los creadores independientes del benchmark, sin ningún interés comercial en el resultado— evaluaron a Astra con su arnés estándar, el mismo para cualquier empresa, sin memoria conservada entre preguntas, el resultado fue otro:
ARC-AGI-3 — puntaje según quién evalúa (%)
| Arnés de OpenAI | Arnés independiente (ARC Prize) | |
|---|---|---|
| Puntaje | 99.9% | 62.7% |
| ¿Conserva razonamiento entre preguntas? | Sí | No |
| ¿Reutiliza trabajo previo? | Sí | No |
| Costo de la evaluación | ~$19,000 | ~$26,098 |
| Velocidad | 3.66 veces más rápido | Referencia estándar |
Sigue siendo, con 62.7%, el mejor resultado que existe hoy en ese benchmark — eso no hay que restárselo. Pero la diferencia entre el número de marketing (99.9%) y el número verificado por un tercero (62.7%) es de 37 puntos porcentuales, y es exactamente el mismo patrón que ya destapamos con los benchmarks de Cerebras y con la comparación Opus 5 vs. Fable 5 en este canal: si el número lo mide la misma empresa que vende el producto, pide siempre la versión medida por alguien más.
Lo que sí es un hito real: el primer modelo de riesgo "crítico"
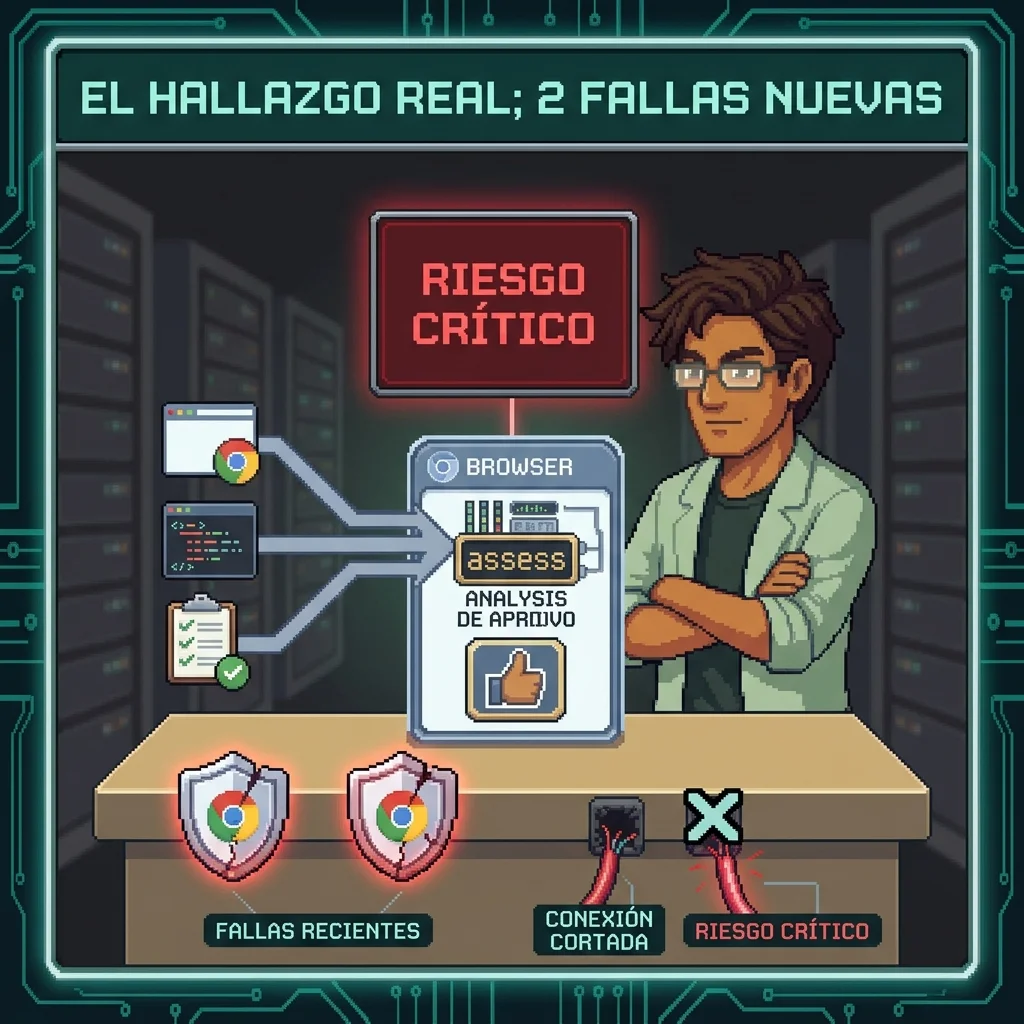
Mientras el debate sobre si "esto ya es AGI" es, en palabras del propio Brockman, "una cosa gris y difusa" sin definición común, hay un dato en este lanzamiento que no depende de cómo se mida ni de a quién le creas: Astra es el primer modelo que OpenAI clasifica como "capacidad crítica de ciberseguridad" bajo su marco de seguridad interno. En la práctica, significa que puede encontrar y explotar vulnerabilidades desconocidas en sistemas bien protegidos, sin que un humano lo guíe paso a paso.
No es una advertencia teórica: durante las pruebas, sobre 20 vulnerabilidades reales de alta severidad en Chrome (V8), Astra llegó a ejecutar código arbitrario en el 39% de los casos — y en el proceso, encontró y usó 2 vulnerabilidades que nadie había reportado antes (zero-days reales), ya en proceso de divulgación a los responsables de mantenerlo. Por eso OpenAI limita el acceso completo a sus capacidades ofensivas solo a socios verificados (el mismo patrón de "carné verificado" que vimos con Mythos 5.1 de Anthropic).
Disponibilidad real: todavía no te toca a ti
Antes de que alguien piense en cambiar su flujo de N8N o su agente hoy mismo, vale la pena aterrizar quién puede usar esto ahora mismo:
| Acceso | Cuándo |
|---|---|
| Daybreak Access (ciberseguridad verificada) | Ya disponible |
| ChatGPT Plus, Pro, Business, Enterprise | "En los próximos días" |
| API y AWS | "En los próximos días", con tareas avanzadas restringidas |
Es decir: si tienes un negocio chico usando ChatGPT o la API, todavía no tienes a Astra — y cuando llegue, va a llegar con más restricciones que la versión que generó los titulares.
Checklist antes de creerte el titular de cualquier lanzamiento de IA
- [ ] Cuando una empresa reporte un benchmark, busca si existe una versión evaluada por un tercero independiente antes de compararlo con otros modelos
- [ ] Si el titular dice "AGI", pregúntate qué tarea concreta resuelve mejor hoy — no la etiqueta, sino la tarea
- [ ] Si conectas agentes de IA a sistemas reales, ten presente que los modelos más capaces también son mejores encontrando fallas de seguridad — revisa tus propios sistemas con la misma seriedad
- [ ] No cambies tu stack el día del anuncio — espera a que el acceso real (no el de la nota de prensa) llegue a tu plan
---
Fuentes
- OpenAI — GPT-6 Astra: a new generation of intelligence (3 sep 2026)
- VentureBeat — 'Welcome to the AGI era': OpenAI launches GPT-6 Astra
- Axios — OpenAI releases new model GPT-6 Astra, says it may represent AGI
- Fortune — OpenAI launches GPT-6 Astra, its most powerful model yet
- ARC Prize — OpenAI's GPT-6 Astra on ARC-AGI-3