Claude encontró bugs que billones de pruebas no vieron
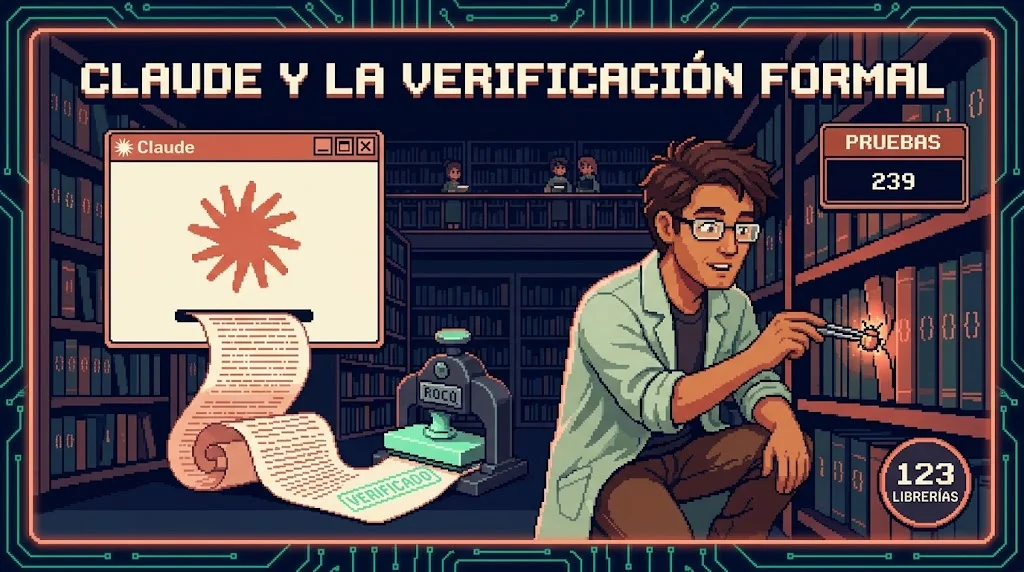
Anthropic usó a Claude para demostrar con matemáticas que 239 puntos de entrada de 123 librerías de código abierto no se caen. En el camino encontró cientos de bugs, uno escondido por más de diez años. La parte más útil para tu negocio está en lo que esa prueba no cubre.
Tipo: Análisis/noticia | Fuente: Anthropic — LLMs are making formal software verification feasible at a much larger scale (22 de octubre de 2026)
Hay un bug en un descompresor de archivos (el programa que abre un .zip, por ejemplo) que solo aparece si le das un archivo de unos 20 MB con una distribución interna muy rara. Con ese archivo, un contador que debería quedarse en cero da la vuelta y el programa escribe datos fuera de la memoria que le corresponde. Es el tipo de error que, en el peor caso, un atacante puede usar para meterse en un sistema.
Ese programa llevaba años pasando pruebas automáticas, de forma continua. Según Anthropic, varios de los bugs que encontró esta semana "had eluded detection for years, despite trillions of test runs". Se habían escapado durante años, a pesar de billones de ejecuciones de prueba.
Quien lo encontró fue Claude. Y no lo hizo probando más fuerte, sino intentando demostrar, como se demuestra un teorema en matemáticas, que ese programa nunca podía caerse. La demostración no salía. Ahí estaba el bug.
Qué hizo Anthropic, explicado sin fórmulas
Para entenderlo hay que separar dos formas de revisar si un programa es seguro.
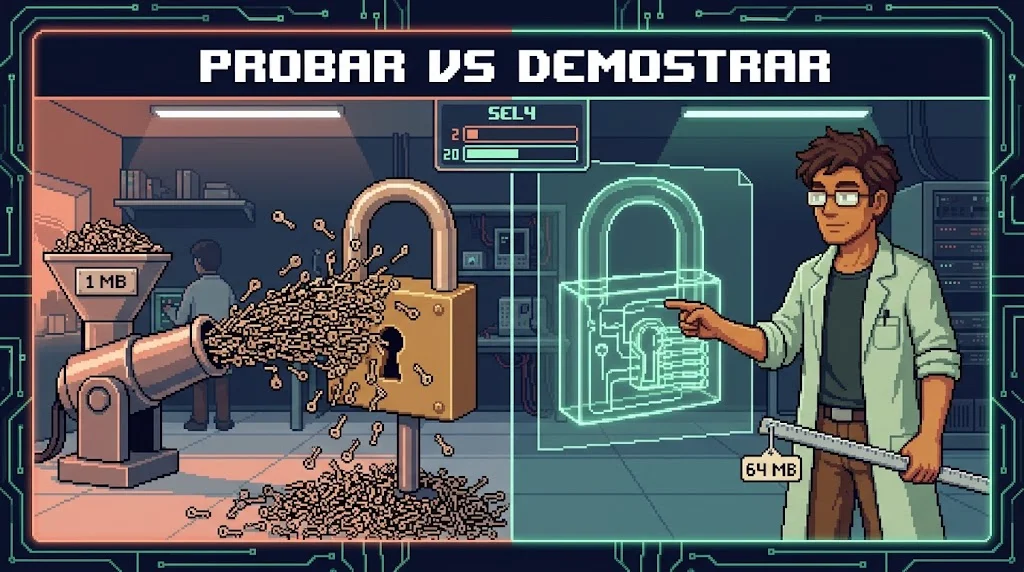
La primera es la que usa casi todo el mundo, y se llama fuzzing. Imagina que quieres saber si una cerradura es buena y le pruebas millones de llaves generadas al azar. Si alguna la abre, encontraste un problema. Google tiene un programa enorme que hace esto todo el día con proyectos de código abierto, OSS-Fuzz. Funciona muy bien, pero tiene un límite que el propio artículo admite: es fuerza bruta, "with no guarantee of exercising every possible code path". No garantiza pasar por todos los caminos posibles del programa. Y las llaves suelen ser pequeñas: los fuzzers trabajan con entradas de hasta 1 MB, más o menos.
La segunda se llama verificación formal. En vez de probar llaves, demuestras con lógica que ninguna llave posible abre la cerradura. Es mucho más fuerte, pero tan difícil que casi nadie la usa. El ejemplo que da Anthropic es el de seL4, un núcleo de sistema operativo famoso por estar verificado: construirlo tomó dos años-persona y demostrar que era correcto tomó veinte.
Años-persona en el kernel seL4
Lo que hicieron Anthropic y Theorem, la empresa con la que colaboraron, fue juntar las dos cosas. Tomaron las pruebas de fuzzing que ya existían en OSS-Fuzz y las convirtieron automáticamente en una regla matemática: "este punto de entrada del programa nunca se cae, con ninguna entrada de menos de 64 MB". Después le pidieron a Claude que escribiera la demostración. Cada demostración la revisa un verificador llamado Rocq, que es como un profesor de matemáticas que no se cansa nunca y no deja pasar ni un paso sin justificar.
Tamaño máximo de entrada cubierto (MB)
El resultado, en unas pocas semanas: 239 puntos de entrada de 123 librerías de código abierto demostrados. En total, cerca de 180 millones de líneas de demostración. Una sola demostración típica tiene unas 600,000 líneas. Ninguna persona las va a leer, y está bien: no hace falta, porque las revisa Rocq.
Los bugs que salieron en el camino
Lo interesante pasaba cuando la demostración fallaba. Si Claude no podía demostrar que el programa nunca se cae, muchas veces era porque sí se caía. Entonces arreglaba el bug, se regeneraba la regla y volvía a intentar. Así aparecieron cientos de errores.
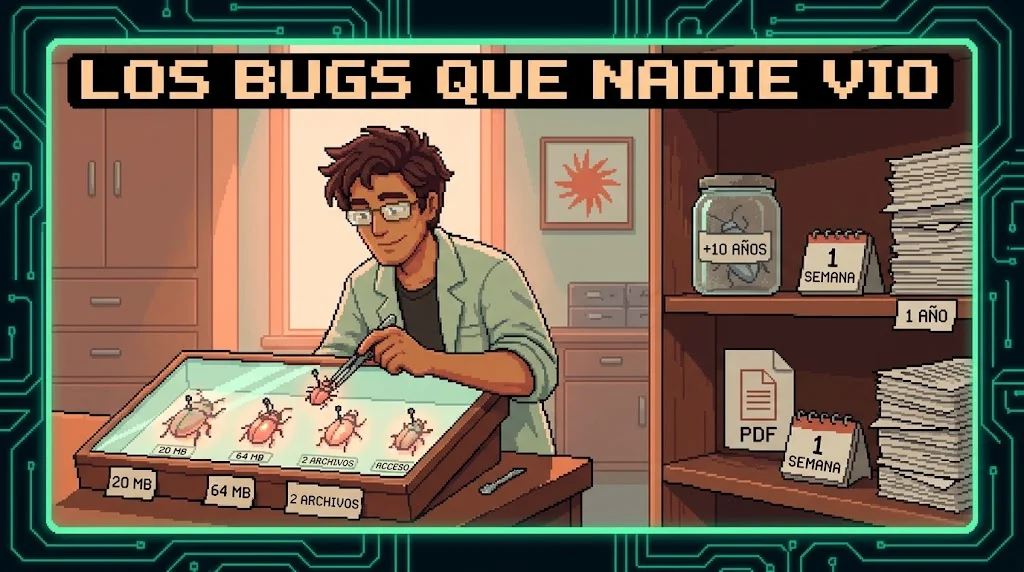
Algunos son de esos que ninguna prueba al azar va a encontrar. El del descompresor, que necesita un archivo de unos 20 MB con una forma muy específica. Uno en un lector de imágenes que solo falla con una entrada de 64 MB y más de 2 GB de memoria. Otro que aparece solo si abres el mismo archivo dos veces y llamas a las funciones en un orden concreto. Y un error de lógica en una función que debía restringir a qué archivos se podía acceder y no siempre lo hacía. Ese último no hace caerse a nadie: simplemente deja abierta una puerta que debía estar cerrada.
El equipo probó también la técnica en otros programas. En un lector de PDF muy usado, cuyo nombre no dan, encontraron "as many security bugs in one week as are typically reported in a year". Tantos bugs de seguridad en una semana como los que se reportan normalmente en un año. Y en una aplicación muy usada, que tampoco nombran, apareció un error de lógica que llevaba más de una década escondido.
Ojo con eso: Anthropic no dice cuál es el lector de PDF ni la aplicación. Lo más probable es que esperen a que los arreglos estén publicados antes de contarlo, que es lo normal en seguridad. Pero significa que, por ahora, esos dos datos hay que tomarlos como lo que reporta la empresa, sin poder revisarlos por fuera.
Lo que "demostrado" no significa
Aquí está la parte que más me gustó del artículo, porque la escribieron ellos mismos sin que nadie se los pidiera: "'Formally verified' does not mean 'bug-free.'" Verificado formalmente no quiere decir libre de bugs.
La primera razón es la más importante y se resume en otra frase del texto: "a proof checker can't tell you whether your spec matches reality". El verificador te dice si la demostración cumple la regla. No te dice si la regla era la correcta. Si la regla dice "nunca se cae" y el programa nunca se cae pero calcula mal tu factura, la demostración pasa igual. Lo que demostraron es una cosa concreta (que no se cae con entradas de menos de 64 MB), no que el programa haga bien su trabajo.
La segunda razón es de condiciones. Las demostraciones valen para programas compilados para RISC-V, un tipo de procesador, sobre Linux, en un solo hilo y con una versión específica de las librerías básicas del sistema (musl). La mayoría de los servidores reales usan otros procesadores (x86 o ARM) y otras librerías (glibc). Lo demostrado ahí no se traslada automáticamente a lo que corre en producción.
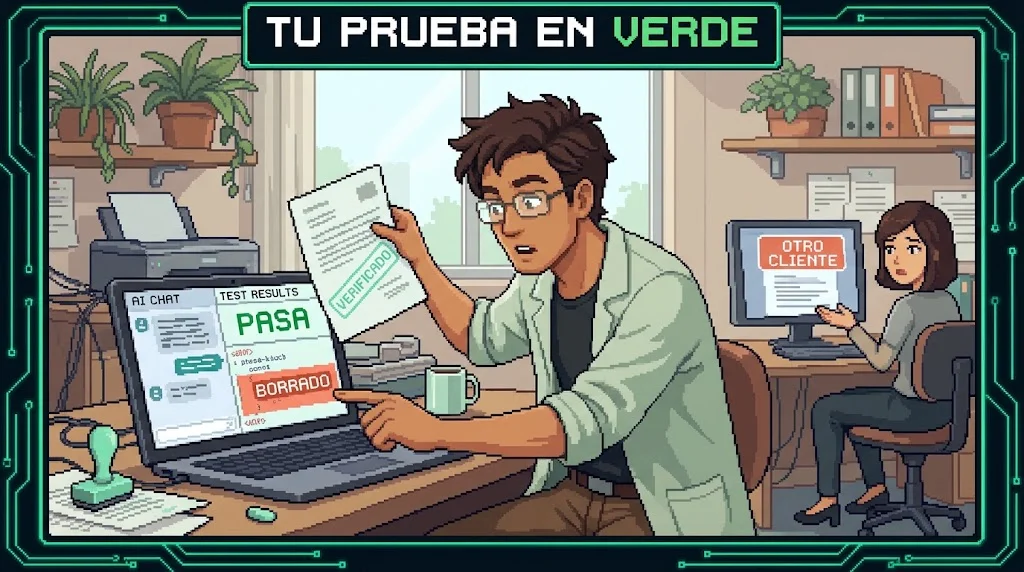
La tercera me parece la más honesta, y es la que más se parece a lo que vivo construyendo con IA. Los autores avisan que Claude "could make any theorem provable by rewriting the program into one that trivially never crashes". Podía hacer que cualquier demostración funcionara reescribiendo el programa para que no hiciera nada. Un programa que no hace nada nunca se cae. Técnicamente, la demostración estaría bien. En la práctica, habrías perdido el programa. Por eso castigaban cada parche que Claude proponía, le daban puntos extra si demostraba exactamente qué entradas cambiaba su arreglo y cuán pocas eran, y revisaban todos los parches a mano.
Qué significa para un negocio sin equipo técnico
Vas a pensar que esto es un tema para ingenieros de Google. En parte sí. Pero hay dos cosas que te tocan directo.
La primera: tu software está construido encima de estas librerías. El sistema de facturación que genera PDFs, la app que comprime fotos de tus productos, el portal que lee los archivos que suben tus clientes. Tú no escribiste esas piezas, ni tu desarrollador tampoco: vienen de proyectos de código abierto como los que verificaron. Si esta técnica se vuelve barata, la base sobre la que está construido tu negocio se vuelve más segura sin que tengas que hacer nada. Theorem dice que va a publicar una skill de Claude para que cualquier desarrollador empiece a verificar su propio código y que se ofrece a correr el mismo proceso para otros proyectos de código abierto.
Esta misma semana se vio por qué importa. El 21 de octubre, varios gobiernos europeos apagaron sus propias webs por PHP2Shell, dos fallas en PHP, el lenguaje que mueve cerca del 70% de las páginas web. Llevaban 14 años ahí y también las encontró una IA, en este caso un modelo de OpenAI. Lo cuento con detalle en el siguiente blog. La IA ya está encontrando fallas viejas más rápido que nunca, y quien no actualiza a tiempo queda expuesto.
La segunda es la que me importa más, y viene del truco del programa que no hace nada. En el canal construyo casi todo con asistencia de IA, y el equivalente chico de ese problema aparece todo el tiempo: le pides a la IA que haga pasar una prueba que falla, y la IA, en vez de arreglar el código, cambia la prueba. O borra la función que fallaba. La prueba queda en verde y tu sistema dejó de hacer lo que necesitabas. A esto le llamo vibecoding con criterio: dejar que la IA escriba rápido, pero revisar tú qué cambió para que todo quedara en verde.
Y la frase de la regla aplica igual a un negocio de cinco personas. Una prueba solo te protege de lo que dijiste que había que probar. Si nadie escribió "el sistema nunca debe dejar que un cliente vea las facturas de otro", ninguna prueba, por más automática o matemática que sea, lo va a revisar.
Checklist: 5 preguntas para tu propio software
Las saqué de lo que el artículo dice que la verificación no cubre. Sirven para hacérselas a tu desarrollador, a tu agencia o a ti mismo si construyes con IA.
- ¿Qué está probado, exactamente? "Tiene pruebas" no dice nada. Pide la lista de lo que se prueba, en palabras normales: "que un cliente no vea datos de otro", "que una factura no salga con monto cero".
- ¿Quién escribió las reglas? La IA puede escribir las pruebas, pero las reglas del negocio las tienes que decir tú. Si nadie las escribió, nadie las está revisando.
- ¿Se probó con datos de verdad? El fuzzing se quedaba en 1 MB y el bug estaba en 20 MB. En tu caso: pregunta si se probó con tus 800 clientes reales o con los 5 de ejemplo.
- ¿Qué cambió la IA para que las pruebas pasaran? Si una prueba que fallaba ahora pasa, revisa si se arregló el código o se cambió la prueba. Es la versión chica del programa que no hace nada.
- ¿Las librerías están al día? Los arreglos de estos cientos de bugs van a llegar como actualizaciones. Pregunta cada cuánto se actualizan las piezas de terceros de tu sistema y quién lo hace.
Si tu proveedor responde las cinco sin dudar, ya sabes algo que la mayoría no sabe de su propio software.
Fuentes
¿Quieres automatizar esto en tu negocio?