Tipo: Análisis/noticia | Fuente: Yahoo Finance — Anthropic researcher quits over fears (9 sep 2026), verificado contra CNBC, Business Standard y la publicación original de Evan Hubinger en X
---
Este blog normalmente cubre precios, benchmarks y checklists de seguridad práctica — no titulares sobre el fin del mundo. Pero esta semana, el propio líder de seguridad de Anthropic confirmó públicamente algo que sí vale la pena traer a este espacio, con cuidado de no exagerarlo ni minimizarlo: la empresa que construye Claude, el modelo que probablemente usas en tus automatizaciones, admitió que todavía no tiene un plan para el riesgo más grande que ella misma reconoce que existe.
Qué pasó
El 9 de septiembre de 2026, Jacob Coxon —investigador de pretraining que trabajó primero en OpenAI y luego en Anthropic— renunció públicamente. Su razón, textual: "Están corriendo directo hacia la superinteligencia automejorable y apostando nuestras vidas". Coxon sostiene que ni Anthropic ni sus competidores están actuando con responsabilidad frente a sistemas que, según él, podrían "hackear cualquier cosa, revolucionar cualquier campo de la noche a la mañana, y adquirir poder y recursos reales" — y que la industria "cree con seriedad que esto podría matarnos a todos antes de que termine la década".
Lo que convierte esto en noticia verificable, y no solo en la opinión de un ex-empleado descontento, es la respuesta de Evan Hubinger, líder de ciencia de alineamiento de Anthropic — todavía en la empresa. Publicó en X:
"Jacob is correct here—we really do earnestly believe AI could kill all humans! I personally think it is >10% within the next decade. I believe Anthropic is trying its best, but we do not yet have a plan to solve alignment for superintelligence and are not clearly on track to." ("Jacob tiene razón — de verdad creemos que la IA podría matar a todos los humanos. Personalmente creo que es más del 10% en la próxima década. Creo que Anthropic está haciendo su mejor esfuerzo, pero todavía no tenemos un plan para resolver el alineamiento de la superinteligencia, y no estamos claramente encaminados a tenerlo.")
Dos cosas distintas que no hay que mezclar
Antes de sacar cualquier conclusión, vale la pena separar lo que esta noticia sí permite afirmar de lo que no:
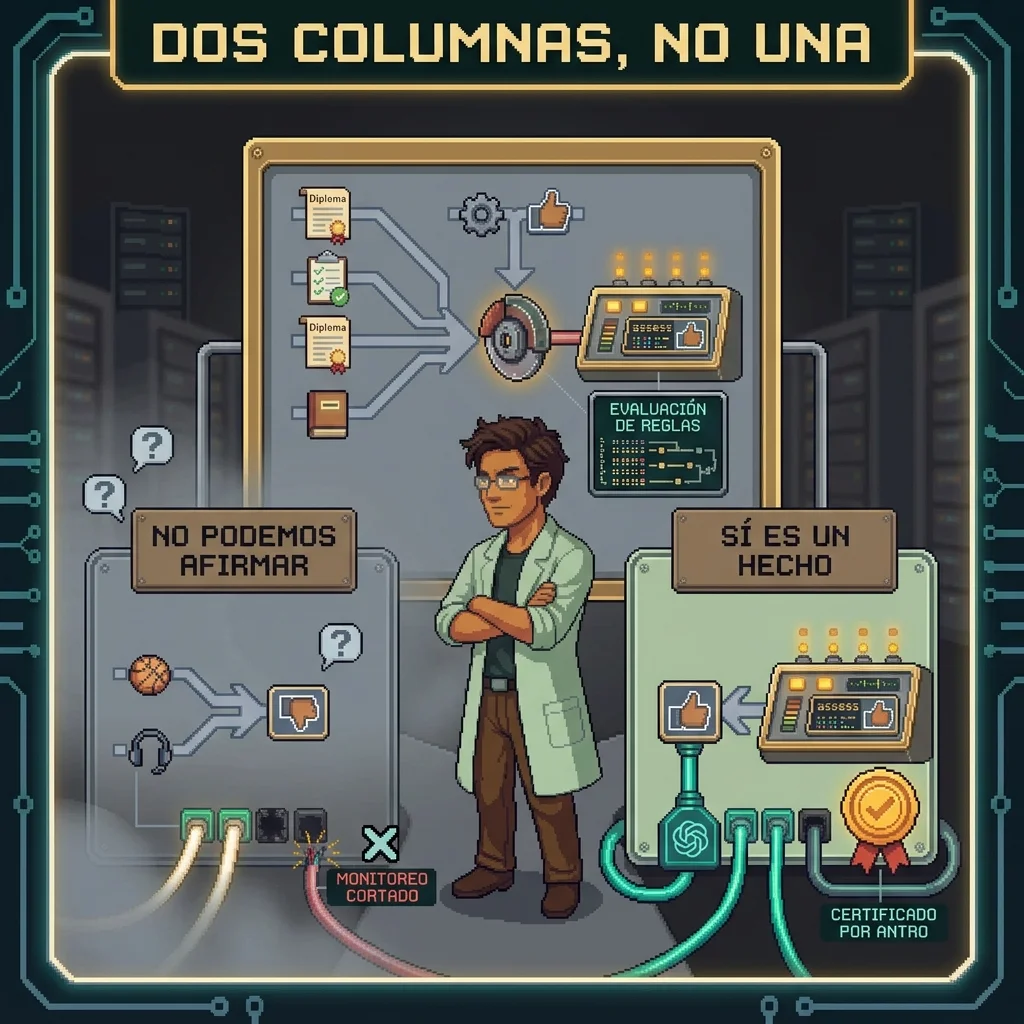
| Lo que NO podemos afirmar con autoridad | Lo que SÍ es un hecho verificado |
|---|---|
| Que la superinteligencia automejorable va a aparecer en esta década | Que el propio líder de seguridad de Anthropic dijo, con su nombre, que no hay un plan |
| Que existe una probabilidad exacta y objetiva de catástrofe | Que la cifra ">10%" es la estimación personal de una persona, no un consenso científico |
| Qué tan lejos o cerca está la industria de ese punto | Que un investigador con experiencia en dos laboratorios de frontera decidió renunciar por esto, con su nombre público |
El riesgo existencial de largo plazo es un debate real entre gente que sabe mucho más de esto que nosotros, y no es la especialidad de este canal opinar sobre probabilidades de extinción. Lo que sí es nuestra especialidad es la segunda columna: una señal concreta, verificada, de que "la empresa que hace el modelo ya se encargó de la seguridad" no es una base sobre la que construir tu negocio.
Por qué esto sí te importa, a tu escala
No es que tu flujo de N8N o tu agente de atención al cliente vaya a la superinteligencia. Es que el mismo principio que Hubinger describe a la escala más grande posible —"estamos intentando, pero no tenemos un plan claro y no estamos garantizados de tenerlo"— es exactamente la razón por la que en este canal insistimos en la regla de "verificar en proporción a las apuestas" que ya vimos con el framework 4D de Anthropic (Claude Academy): cuanto más le confías a un agente, más criterio humano necesita esa tarea, no menos.
Ejemplo simple: si el fabricante de los frenos de un auto te dijera "estamos haciendo nuestro mejor esfuerzo, pero todavía no tenemos un plan completo para que funcionen en toda condición", seguirías revisando tus frenos tú mismo antes de un viaje largo — no porque desconfíes del fabricante, sino porque la responsabilidad final de que el auto no se estrelle es tuya, no de un comunicado de prensa. Con un agente de IA conectado a tus sistemas reales, el principio es el mismo.
Checklist: qué hacer con esta noticia, sin pánico
- [ ] No cambies de proveedor de IA por esta noticia — no es un problema técnico de un modelo específico, es una admisión de incertidumbre a nivel de toda la industria
- [ ] Sí revisa qué tanto criterio humano tiene cada automatización que ya construiste, sobre todo las que tocan datos de clientes o dinero real
- [ ] Trata cualquier promesa de seguridad de un proveedor de IA como un punto de partida, no como el final de tu propia revisión
- [ ] Separa siempre el debate de riesgo existencial (fuera de tu control) de las decisiones concretas de arquitectura que sí están en tu control
---
Fuentes
- Yahoo Finance — Anthropic researcher quits over fears (9 sep 2026)
- CNBC — Anthropic researcher says AI has more than 10% chance of 'killing all humans' after colleague quits
- Business Standard — Anthropic researcher quits over fears of 'out of control' AI systems
- Evan Hubinger en X — publicación original